Speech-to-text thường bị xem như một API call đơn giản, nhưng với audio nội bộ, video số lượng lớn hoặc thiết bị không muốn phụ thuộc cloud, cách triển khai lại trở thành bài toán riêng. whisper.cpp đáng xem vì nó đưa mô hình Whisper vào một runtime C/C++ tập trung vào việc chạy local, tối ưu tài nguyên và hỗ trợ nhiều loại phần cứng.
whisper.cpp là gì?
whisper.cpp là bản triển khai Whisper bằng C/C++. Repo cung cấp CLI để chạy transcription, model ở định dạng GGML, công cụ quantization và nhiều backend tăng tốc cho CPU, GPU hoặc accelerator khác nhau.
Quickstart của dự án đi theo hướng rất thực dụng: build project, tải model, chạy whisper-cli trên file audio rồi mới mở rộng sang cấu hình phần cứng. README cũng công khai bảng dung lượng model và mức memory tham khảo, từ dòng tiny đến large, giúp người dùng biết trước việc chọn model ảnh hưởng trực tiếp đến tài nguyên.
Vì sao repo này đáng chú ý?
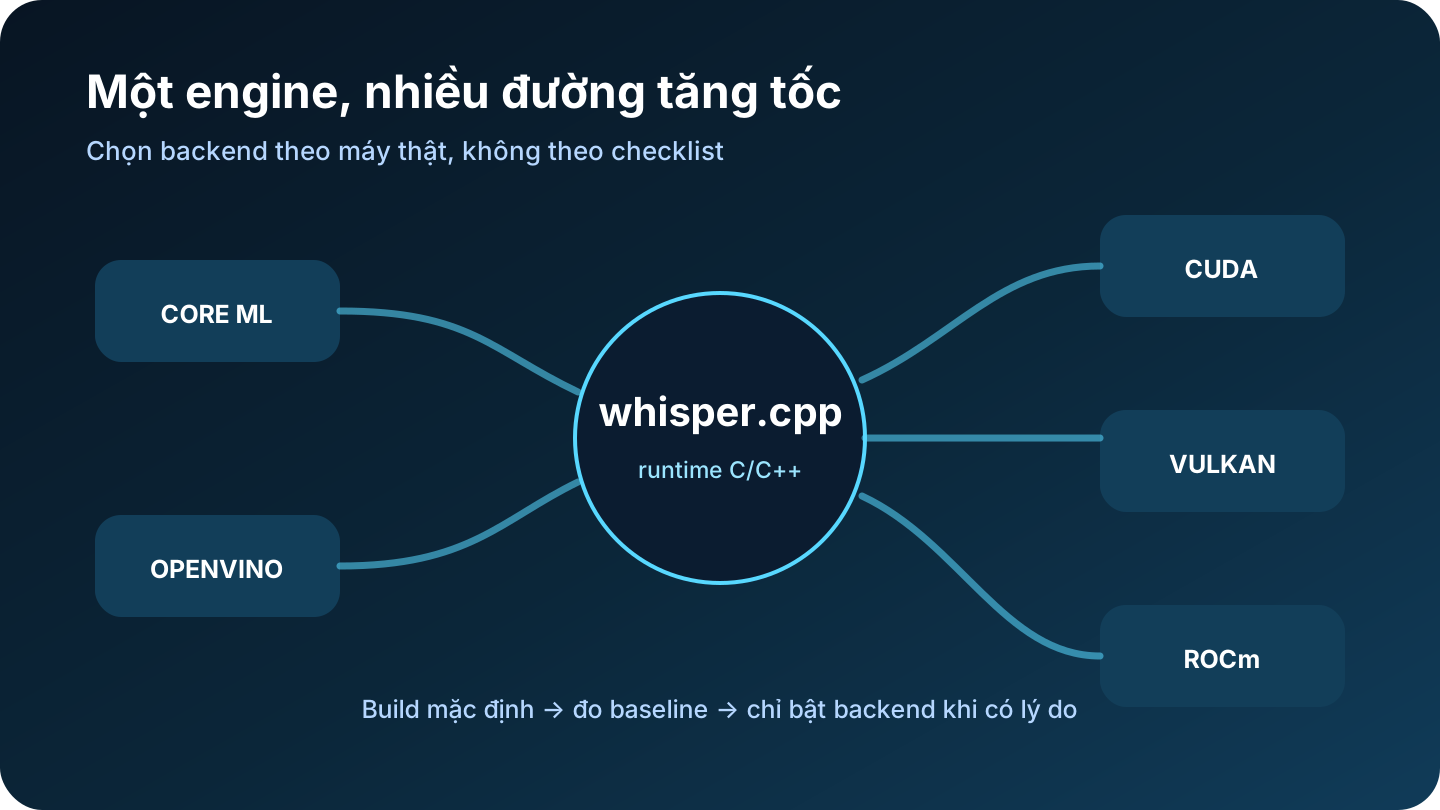
Điểm đáng chú ý đầu tiên là phạm vi phần cứng. Tài liệu hiện có hướng dẫn cho Core ML trên Apple Silicon, OpenVINO, NVIDIA CUDA, Vulkan, AMD ROCm và cả một số NPU Ryzen AI. Điều đó khiến whisper.cpp phù hợp với bài toán mà cùng một engine cần chạy trên nhiều loại máy thay vì chỉ một server GPU cố định.
Thứ hai là khả năng quantization. Với speech-to-text local, giảm memory và làm model dễ chạy hơn trên máy yếu có thể quan trọng hơn việc đạt throughput tối đa. Repo cung cấp flow quantize và chạy lại model đã quantize thay vì buộc người dùng dùng nguyên cấu hình mặc định.
Thứ ba, dự án vẫn có maintenance signal rõ: release v1.9.4 được xuất bản ngày 11/09/2026 và repository có commit mới trong tháng 9/2026.
Khi nào nên dùng?
whisper.cpp phù hợp khi dữ liệu audio không nên rời khỏi máy hoặc mạng nội bộ, khi bạn cần transcription offline, hoặc khi workflow xử lý media có đủ volume để việc gọi API bên ngoài trở thành chi phí đáng kể.
Nó cũng hợp với desktop app, công cụ media local và edge device nơi Python service hoặc cloud dependency là gánh nặng không cần thiết.
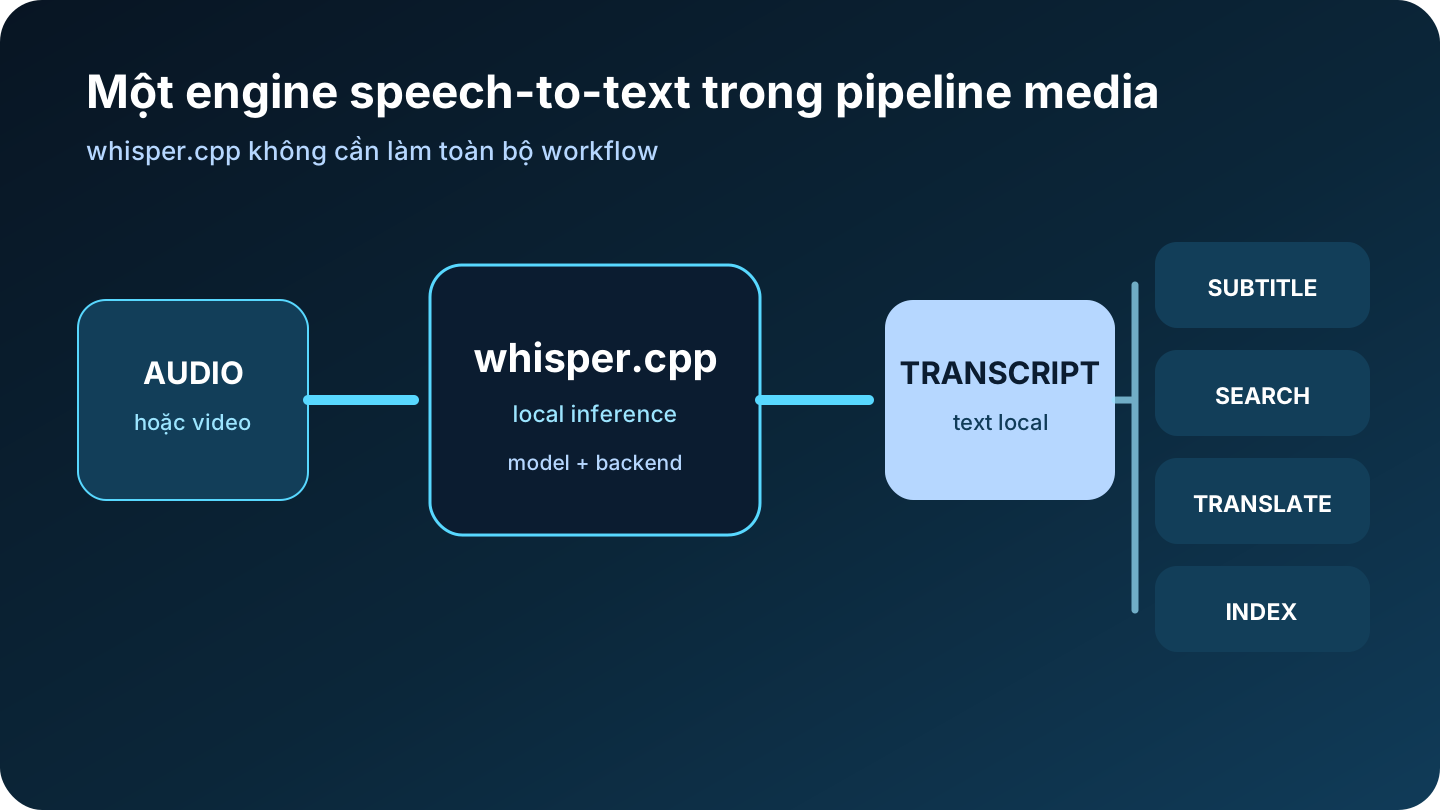
Một use case khác là pipeline video: tách audio, chạy transcription, sau đó đưa transcript sang bước tìm kiếm, subtitle, dịch hoặc indexing. Ở đây whisper.cpp đóng vai trò engine speech-to-text chứ không cố làm toàn bộ pipeline.
Lưu ý trước khi áp dụng
Repo này không che giấu độ phức tạp kỹ thuật. Bạn phải build C/C++, quản lý model và hiểu backend phần cứng nếu muốn tối ưu sâu. Đây không phải trải nghiệm “cài package rồi quên”.
Chất lượng transcript vẫn phụ thuộc model, ngôn ngữ, tiếng ồn, cách thu âm và preprocessing. Việc inference chạy nhanh hơn không đồng nghĩa transcript sẽ chính xác hơn.
Ngoài ra, một số hướng dẫn tăng tốc yêu cầu toolchain riêng. Nếu mục tiêu chỉ là transcription vài file mỗi tuần, thời gian cấu hình CUDA, Core ML hay OpenVINO có thể lớn hơn lợi ích nhận được.
Khi nào chưa cần dùng?
Nếu bạn chỉ xử lý lượng audio nhỏ và một dịch vụ hosted đã đáp ứng tốt về chi phí, privacy và latency, whisper.cpp có thể là tối ưu quá sớm.
Bạn cũng chưa cần dùng nếu team không muốn sở hữu build pipeline native hoặc hỗ trợ nhiều loại máy. Trong trường hợp đó, một wrapper hoặc service speech-to-text đã đóng gói có thể đơn giản hơn.
Phù hợp với ai?
Repo phù hợp với developer làm media pipeline, desktop/edge application, công cụ transcription nội bộ và team cần kiểm soát nơi dữ liệu audio được xử lý.
Nó đặc biệt đáng xem với nhóm đã có nhu cầu local inference thật, thay vì chỉ muốn thử Whisper cho biết.
Bắt đầu thực tế như thế nào?
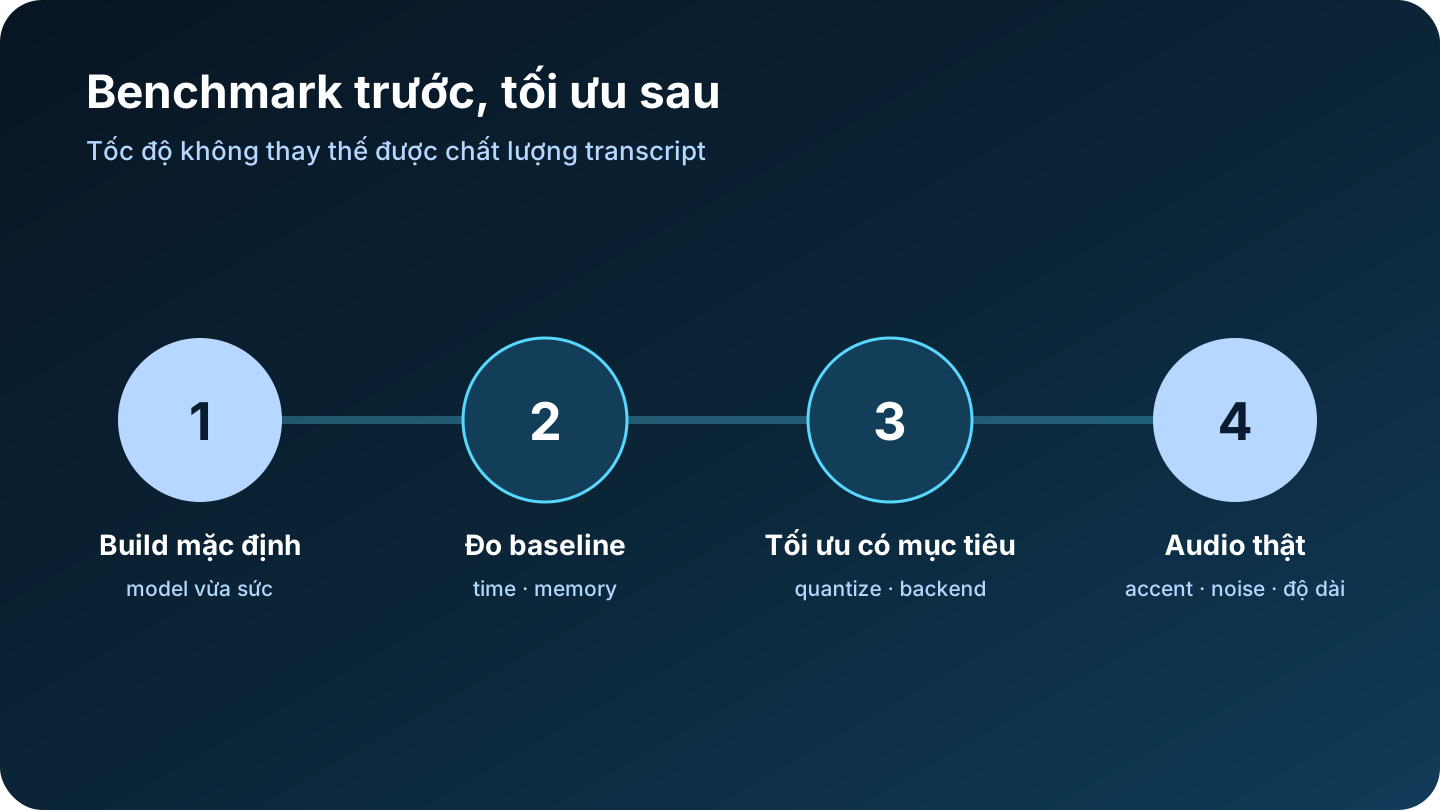
Build cấu hình mặc định trước, dùng model base hoặc tương đương trên một file audio ngắn và ghi lại thời gian xử lý cùng memory. Sau đó mới thử quantization hoặc backend tăng tốc. Bước cuối cùng là chạy trên một tập audio thật có accent, noise và độ dài giống production; đó mới là benchmark quyết định whisper.cpp có phù hợp workflow của bạn hay không.