Tạo ảnh AI đã trở nên tương đối dễ tiếp cận, nhưng video generation vẫn là bài toán nặng hơn nhiều: model lớn, thời gian inference dài, yêu cầu GPU cao và output khó kiểm soát ổn định. Wan2.2 đáng xem vì repo không chỉ trưng demo. Nó cung cấp model, checkpoint và inference code cho nhiều nhánh video generation để team kỹ thuật có thể thử trực tiếp trên hạ tầng của mình.
Wan2.2 là gì?
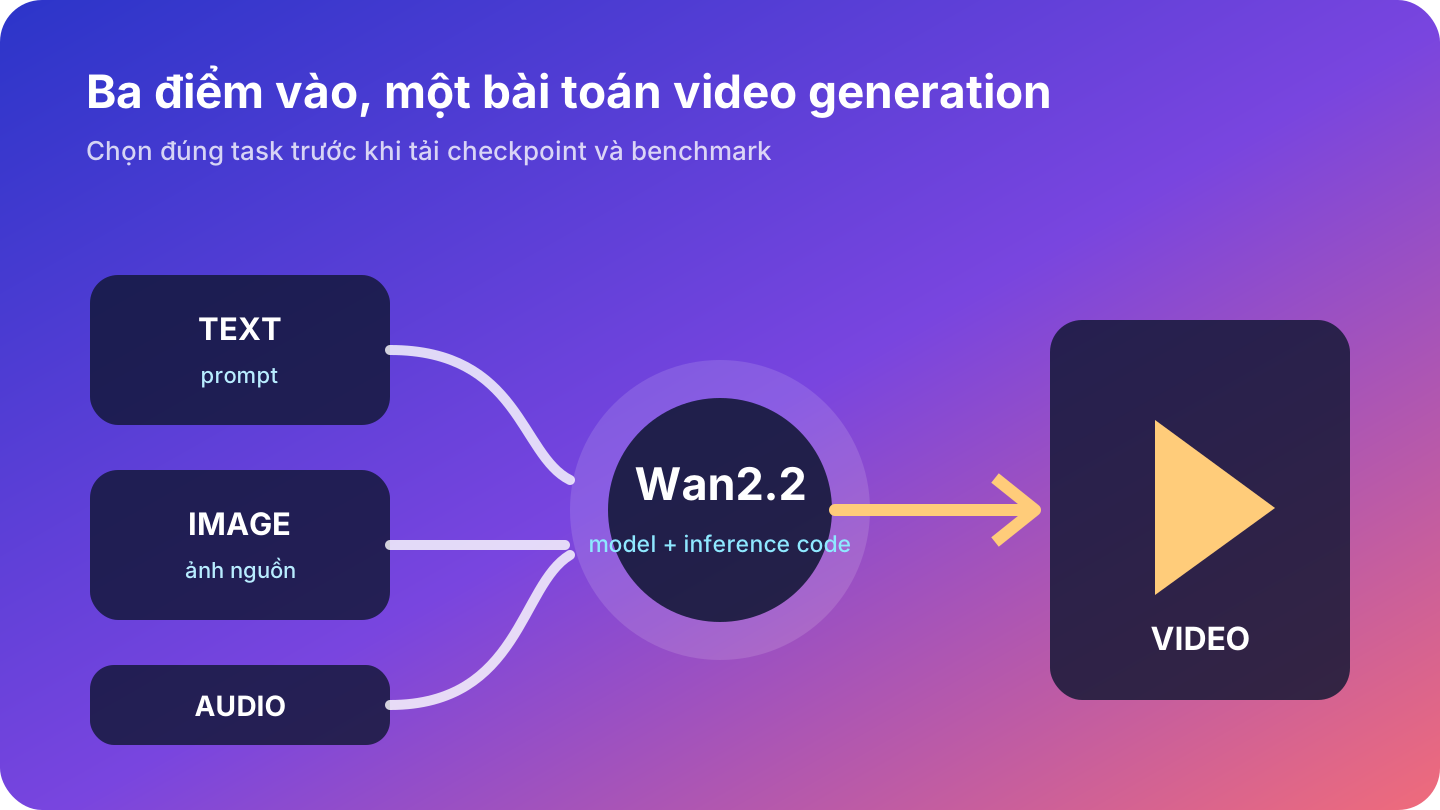
Wan2.2 là repository cho dòng model tạo video của Wan. README hiện mô tả các biến thể text-to-video và image-to-video 14B, hỗ trợ đầu ra 480P và 720P, cùng các nhánh như character animation và speech-to-video.
Flow cài đặt khá trực diện ở mức code: clone repo, cài dependency từ requirements.txt, tải checkpoint rồi chạy generate.py với task tương ứng. Nhưng sự đơn giản ở câu lệnh không nên bị hiểu nhầm là workload nhẹ; chính README đưa ra ví dụ speech-to-video cần GPU có ít nhất 80 GB VRAM cho cấu hình mẫu.
Vì sao repo này đáng chú ý?
Khoảng trống lớn của VibeToolPro hiện tại là multimedia model ở cấp inference. ComfyUI giải quyết orchestration bằng node graph, còn Wan2.2 đi xuống một lớp khác: bản thân model và code chạy video generation. Hai loại repo phục vụ quyết định rất khác nhau.
Wan2.2 cũng bao phủ nhiều input mode. Text-to-video phù hợp cho tạo cảnh từ prompt, image-to-video giúp animate từ ảnh nguồn, còn speech-to-video và character animation mở ra workflow có audio hoặc nhân vật tham chiếu.
README hiện còn mô tả đường chạy multi-GPU bằng FSDP và DeepSpeed Ulysses cho workload nặng. Repository không có GitHub Release “latest” theo API tại thời điểm research, nhưng vẫn có commit mới ngày 21/09/2026, nên activity của mã nguồn vẫn còn rõ.
Khi nào nên dùng?
Repo phù hợp khi team muốn đánh giá nghiêm túc khả năng tự host video generation thay vì chỉ dùng web app. Ví dụ: R&D creative pipeline, tạo clip từ asset có sẵn, thử character animation hoặc kiểm tra xem model open-weight có đáp ứng một format nội dung cụ thể hay không.
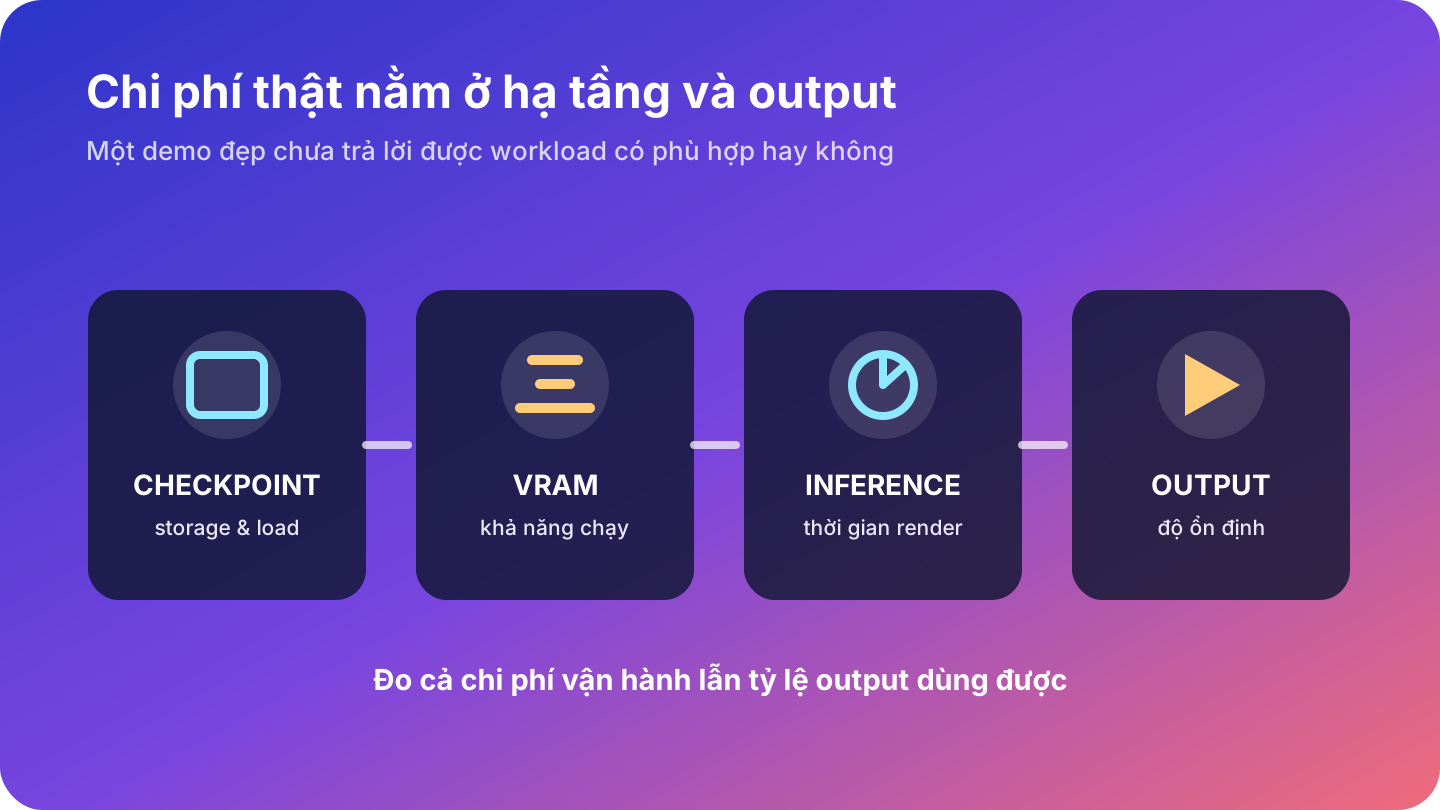
Nó cũng hữu ích khi bạn cần nhìn thấy chi phí thật của video AI. Chỉ sau khi tự chạy một vài workload, team mới biết bottleneck nằm ở VRAM, tốc độ render, storage model hay chất lượng đầu ra.
Lưu ý trước khi áp dụng
Rào cản lớn nhất là hạ tầng. Checkpoint lớn và yêu cầu VRAM cao khiến đây không phải repo phù hợp để “thử nhanh trên laptop”. Ngay cả khi có GPU đủ mạnh, thời gian render và chi phí vận hành vẫn cần được đo riêng.
Video generation còn khó benchmark hơn text. Một clip nhìn ổn trong demo không đảm bảo consistency về nhân vật, chuyển động, camera hay chi tiết khi đổi prompt và asset. Team cần bộ test riêng thay vì đánh giá bằng vài kết quả đẹp.
Dependency cũng là phần phải tính đến. Một số task cần package bổ sung, và workflow speech-to-video có thể kéo thêm hệ thống TTS. Khi ghép nhiều thành phần, debugging sẽ phức tạp hơn đáng kể.
Khi nào chưa cần dùng?
Nếu mục tiêu là tạo vài clip marketing thủ công, một dịch vụ hosted có thể nhanh và rẻ hơn nhiều so với tự dựng model.
Bạn cũng chưa cần Wan2.2 nếu team chưa xác định rõ loại video cần tạo. “Muốn làm video AI” là phạm vi quá rộng; text-to-video, animate nhân vật và speech-to-video có yêu cầu dữ liệu, GPU và cách đánh giá khác nhau.
Phù hợp với ai?
Wan2.2 phù hợp với ML engineer, AI multimedia engineer và nhóm R&D có GPU đủ mạnh để benchmark model. Creator thuần non-code sẽ khó tận dụng repo trực tiếp nếu không có lớp công cụ bên trên.
Bắt đầu thực tế như thế nào?
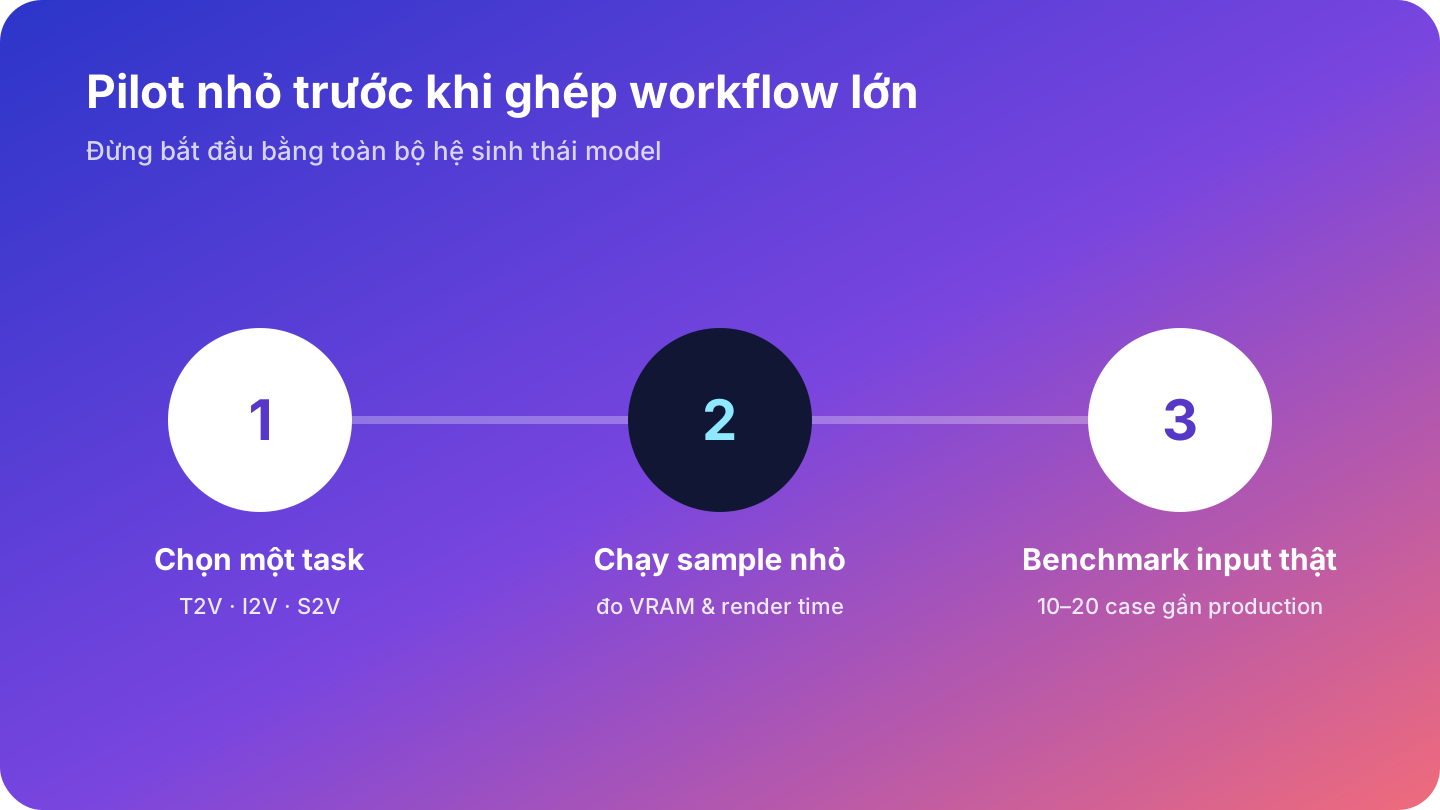
Chọn đúng một task trước, chẳng hạn image-to-video. Dùng checkpoint tương ứng, chạy sample nhỏ và ghi lại VRAM, thời gian inference, độ phân giải cùng tỷ lệ output dùng được. Sau đó thử 10-20 input gần với production. Nếu chất lượng và chi phí còn hợp lý, lúc đó mới đáng kết nối Wan2.2 vào ComfyUI hoặc workflow tạo nội dung lớn hơn.