Tự host model nghe đơn giản cho đến khi bạn phải tự lo chuyện tải model, chạy runtime, mở API, đổi model và nối nó vào những công cụ đang dùng. Nếu mục tiêu ban đầu chỉ là có một model chạy được trên máy cá nhân hoặc một server nội bộ, dựng cả serving stack production thường là quá sớm. Ollama đáng xem vì nó gom phần lớn vòng lặp đó vào một trải nghiệm tương đối gọn: cài runtime, chọn model, chạy và gọi qua API.
Ollama là gì?
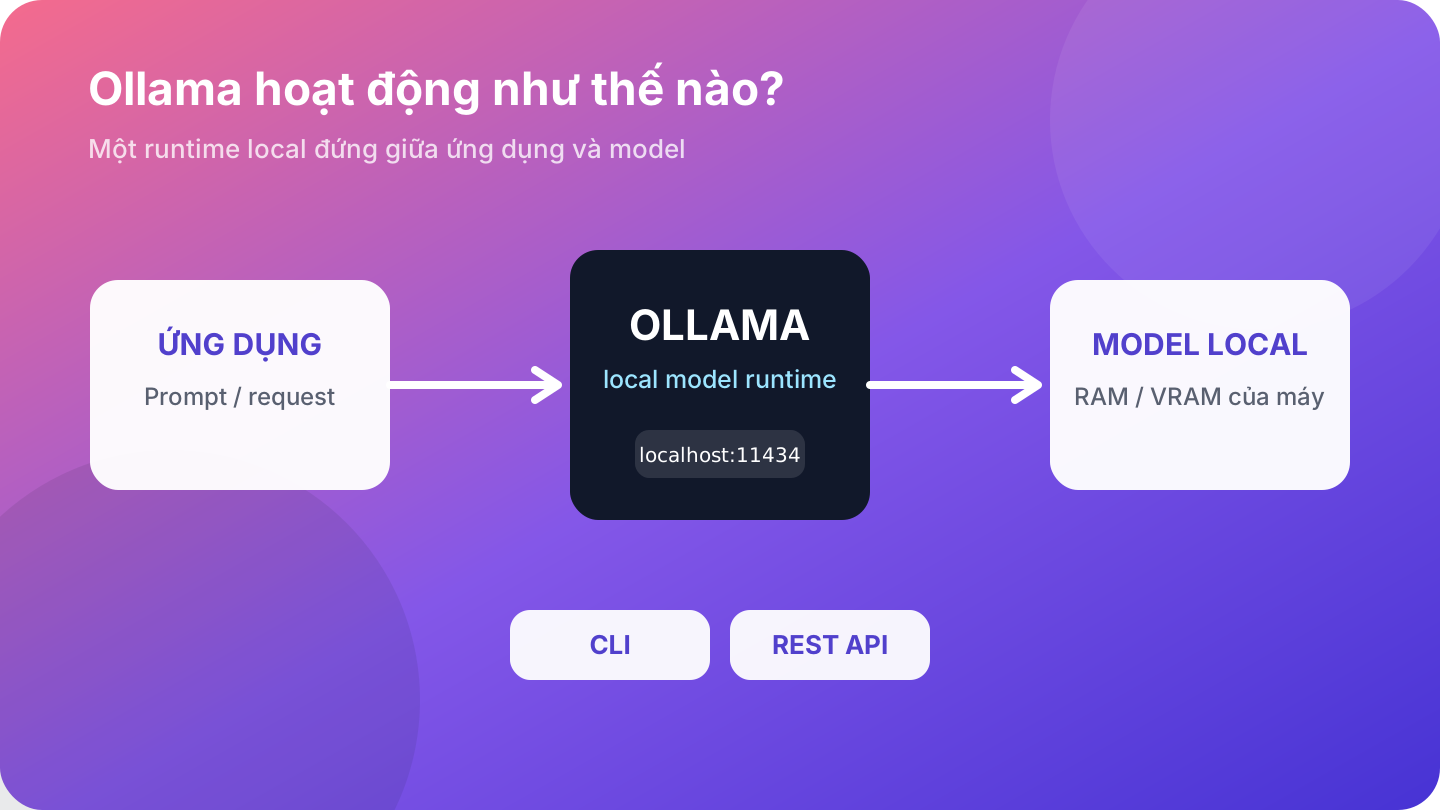
Ollama là một runtime cho phép chạy và quản lý nhiều model ngôn ngữ từ CLI, sau đó cung cấp chúng qua REST API hoặc SDK. README chính thức hiện hướng người dùng bắt đầu trực tiếp bằng lệnh ollama, chạy model bằng ollama run, rồi tích hợp qua Python, JavaScript hoặc HTTP.
Điểm quan trọng không nằm ở việc Ollama tạo ra model mới. Giá trị của nó là lớp vận hành phía trước model: giúp developer có một endpoint local dễ dùng hơn để thử nghiệm, kết nối ứng dụng hoặc cho coding agent gọi model mà không phải tự dựng toàn bộ hạ tầng inference ngay từ đầu.
Vì sao repo này đáng chú ý?
Thứ nhất, đường từ cài đặt đến lần gọi model đầu tiên khá ngắn. Đây là khác biệt lớn với nhiều stack inference vốn yêu cầu hiểu khá nhiều về container, GPU runtime hoặc serving configuration trước khi có kết quả.
Thứ hai, Ollama không chỉ dừng ở CLI. Repo cung cấp REST API và thư viện Python/JavaScript, vì vậy cùng một runtime có thể đi từ thử tay sang prototype ứng dụng mà không phải đổi cách truy cập model ngay lập tức.
Thứ ba, tài liệu hiện còn chỉ ra các tích hợp với nhiều coding agent và công cụ như Claude Code, Codex hay Copilot. Với team đang thử local AI cho development workflow, đây là use case thực tế hơn nhiều so với việc chỉ mở terminal để chat với model.
Tại thời điểm research, repo vẫn hoạt động rất gần ngày xuất bản và có release v0.34.4 ngày 23/09/2026. Đây là maintenance signal tốt, dù activity không tự động đồng nghĩa với việc mọi model hoặc phần cứng đều chạy tối ưu.
Khi nào nên dùng?
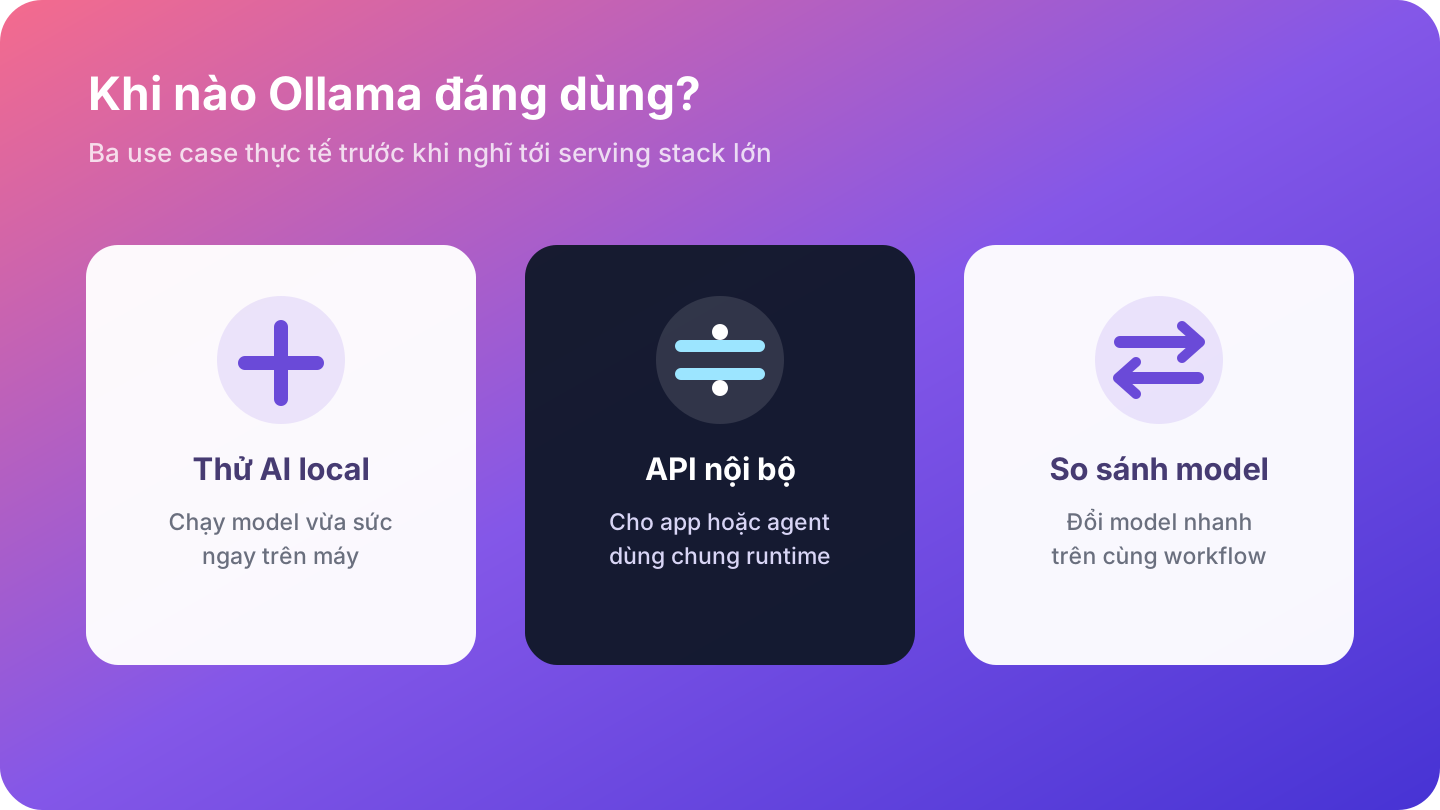
Ollama hợp lý khi bạn muốn thử model open-source trên máy cá nhân, dựng một backend nội bộ nhỏ hoặc cần endpoint local cho prototype mà chưa muốn vận hành Kubernetes, scheduler GPU hay serving engine phức tạp.
Nó cũng hữu ích khi cần kiểm tra một workflow có thực sự hưởng lợi từ local model hay không. Thay vì tranh luận sớm về kiến trúc production, bạn có thể chạy một model vừa sức, nối vào ứng dụng và đo chất lượng thật.
Lưu ý trước khi áp dụng
Trải nghiệm cài đặt đơn giản không làm biến mất giới hạn phần cứng. Model lớn vẫn cần RAM, VRAM và thời gian suy luận tương ứng. Nếu chọn model vượt khả năng máy, bottleneck sẽ nằm ở tài nguyên chứ không phải ở giao diện Ollama.
Ollama cũng không thay thế mọi lớp production serving. Khi traffic tăng, bạn vẫn phải quan tâm đến concurrency, latency tail, monitoring, model lifecycle và cách phân bổ GPU. Nếu mục tiêu là throughput cao trên cụm GPU, một engine như vLLM có thể thuộc lớp bài toán khác.
Ngoài ra, việc API chạy local không tự động giải quyết governance. Team vẫn cần quyết định model nào được dùng, dữ liệu nào được gửi vào model và log nào phải được lưu hoặc loại bỏ.
Khi nào chưa cần dùng?
Bạn chưa cần Ollama nếu toàn bộ sản phẩm đang dùng API hosted ổn định và team chưa có lý do rõ để chạy model riêng. Thêm một local runtime chỉ vì muốn “self-host cho chủ động” có thể tạo thêm việc cập nhật model và hỗ trợ máy người dùng mà chưa tạo ra giá trị.
Nó cũng chưa phải ưu tiên nếu vấn đề chính hiện tại là prompt, dữ liệu hoặc evaluation. Đổi backend inference sẽ không tự sửa chất lượng của một workflow chưa được thiết kế tốt.
Phù hợp với ai?
Ollama phù hợp với developer muốn thử local LLM nhanh, team sản phẩm cần prototype model open-source và nhóm kỹ thuật muốn cung cấp một endpoint AI nội bộ ở quy mô nhỏ đến vừa.
Người mới cũng có thể bắt đầu tương đối dễ, miễn là hiểu rằng model size và phần cứng vẫn là phần phải tự đánh giá.
Bắt đầu thực tế như thế nào?
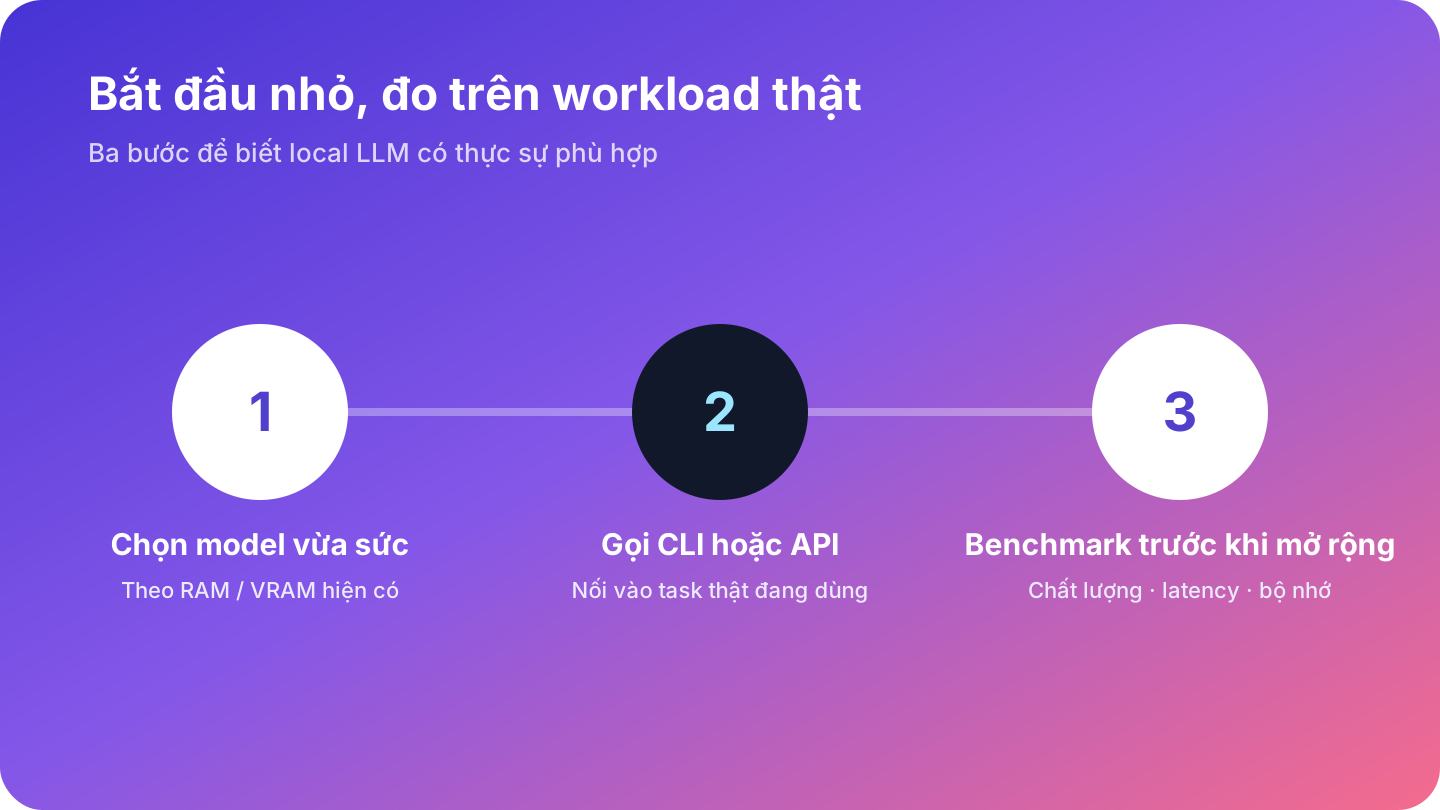
Đừng bắt đầu bằng model lớn nhất. Chọn một model nhỏ hoặc trung bình phù hợp với máy hiện có, chạy một task thật mà bạn đang trả tiền API để xử lý, rồi gọi lại task đó qua REST API của Ollama. Đo ba thứ: chất lượng output, thời gian phản hồi và bộ nhớ sử dụng. Nếu kết quả đủ tốt, lúc đó mới đáng mở rộng sang tích hợp coding agent, ứng dụng nội bộ hoặc server dùng chung.