Rất nhiều workflow AI bắt đầu bằng một bước ít được chú ý: biến file người dùng gửi lên thành text có cấu trúc đủ sạch cho model đọc. Nếu bước này làm kém, mọi thứ phía sau như extraction, summarization hay RAG đều phải xử lý một đầu vào lộn xộn. MarkItDown đáng xem vì nó tập trung đúng vào lớp tiền xử lý đó: chuyển file và tài liệu văn phòng sang Markdown để dùng tiếp trong LLM pipeline.
MarkItDown là gì?
MarkItDown là công cụ Python của Microsoft để chuyển tài liệu sang Markdown. README giải thích lý do chọn Markdown khá rõ: format này gần plain text, vẫn giữ được cấu trúc cần thiết và phù hợp với cách nhiều LLM xử lý nội dung.
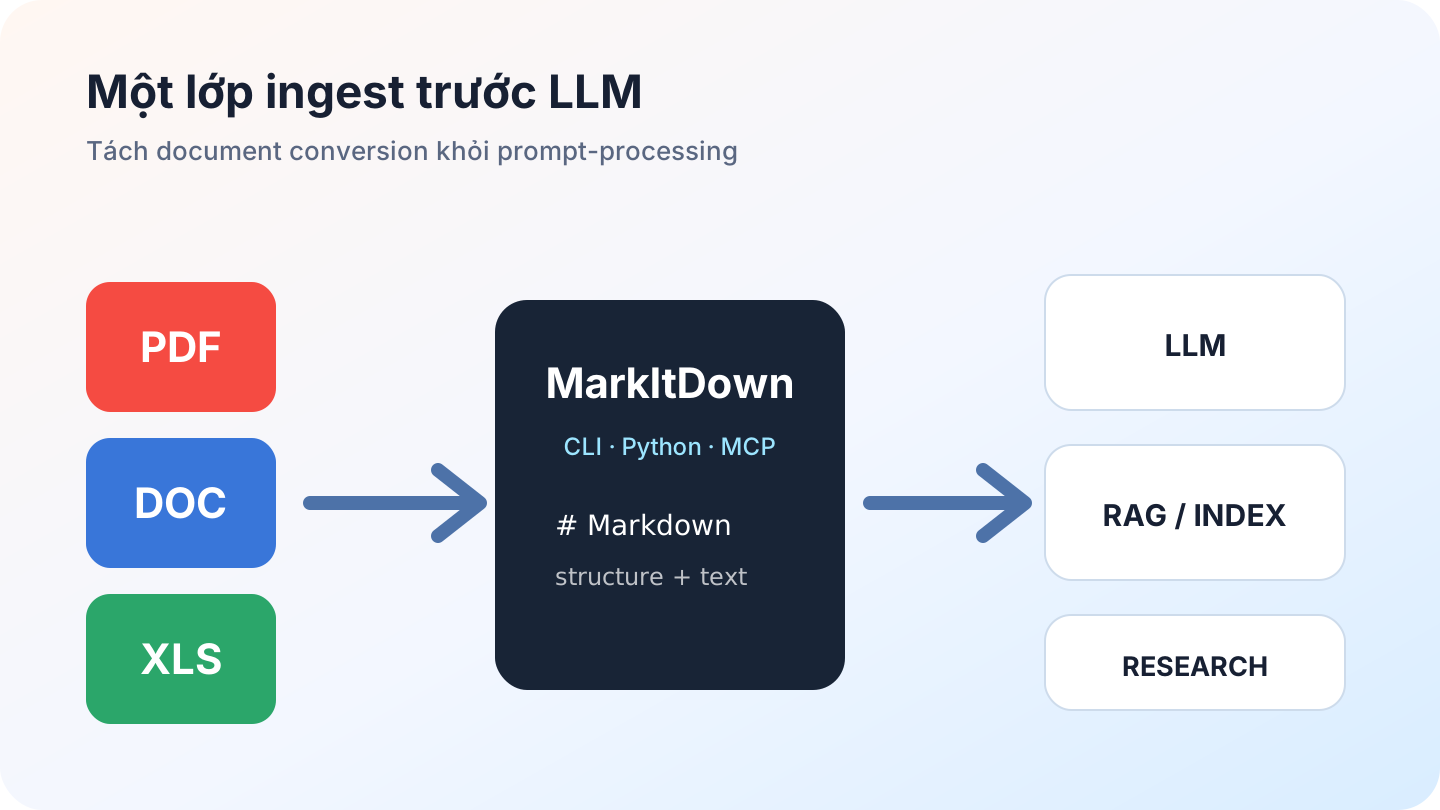
Công cụ có CLI, Python API, Docker và package markitdown-mcp. Cách dùng cơ bản rất nhỏ: cài package rồi chạy markitdown path-to-file.pdf > document.md, hoặc gọi MarkItDown().convert(...) trong Python.
Vì sao repo này đáng chú ý?
Điểm mạnh đầu tiên là nó giải quyết một bước có tính lặp lại cao nhưng thường bị mỗi project tự viết lại. Một team làm research agent, knowledge base hay document extraction đều cần cách biến file thành representation thống nhất trước khi prompt hoặc index.
Thứ hai, MarkItDown được thiết kế như library và CLI để nhúng vào hệ thống khác, không cố trở thành end-user app. README hiện nói rõ phạm vi đóng góp ưu tiên fidelity của converter, CLI, MCP package, test và tooling. Điều này giúp ranh giới sản phẩm tương đối dễ hiểu.
Thứ ba, repo có đường mở rộng qua plugin thay vì nhồi mọi định dạng vào core. Với workflow doanh nghiệp, đây là điểm thực tế vì các loại file hiếm hoặc parser đặc thù thường cần dependency riêng.
Tại thời điểm research, repository có release v0.1.8 ngày 21/09/2026 và commit mới trong cùng tháng. Maintenance signal vì vậy khá rõ.
Khi nào nên dùng?
MarkItDown phù hợp khi workflow của bạn nhận nhiều tài liệu nhưng model phía sau chỉ cần text có cấu trúc. Ví dụ: trợ lý đọc tài liệu, pipeline research, extraction từ PDF, chuyển file văn phòng trước khi index hoặc chuẩn hóa input cho agent.
Nó đặc biệt hữu ích khi bạn muốn tách “document conversion” thành một module riêng. Làm vậy giúp dễ thay parser, log lỗi và kiểm tra fidelity hơn là trộn mọi thứ vào prompt-processing code.
MCP package cũng đáng chú ý nếu team đang dùng agent có khả năng gọi tool. Thay vì để agent tự suy nghĩ cách đọc từng loại file, bạn có thể đưa conversion thành một capability rõ ràng.
Lưu ý trước khi áp dụng
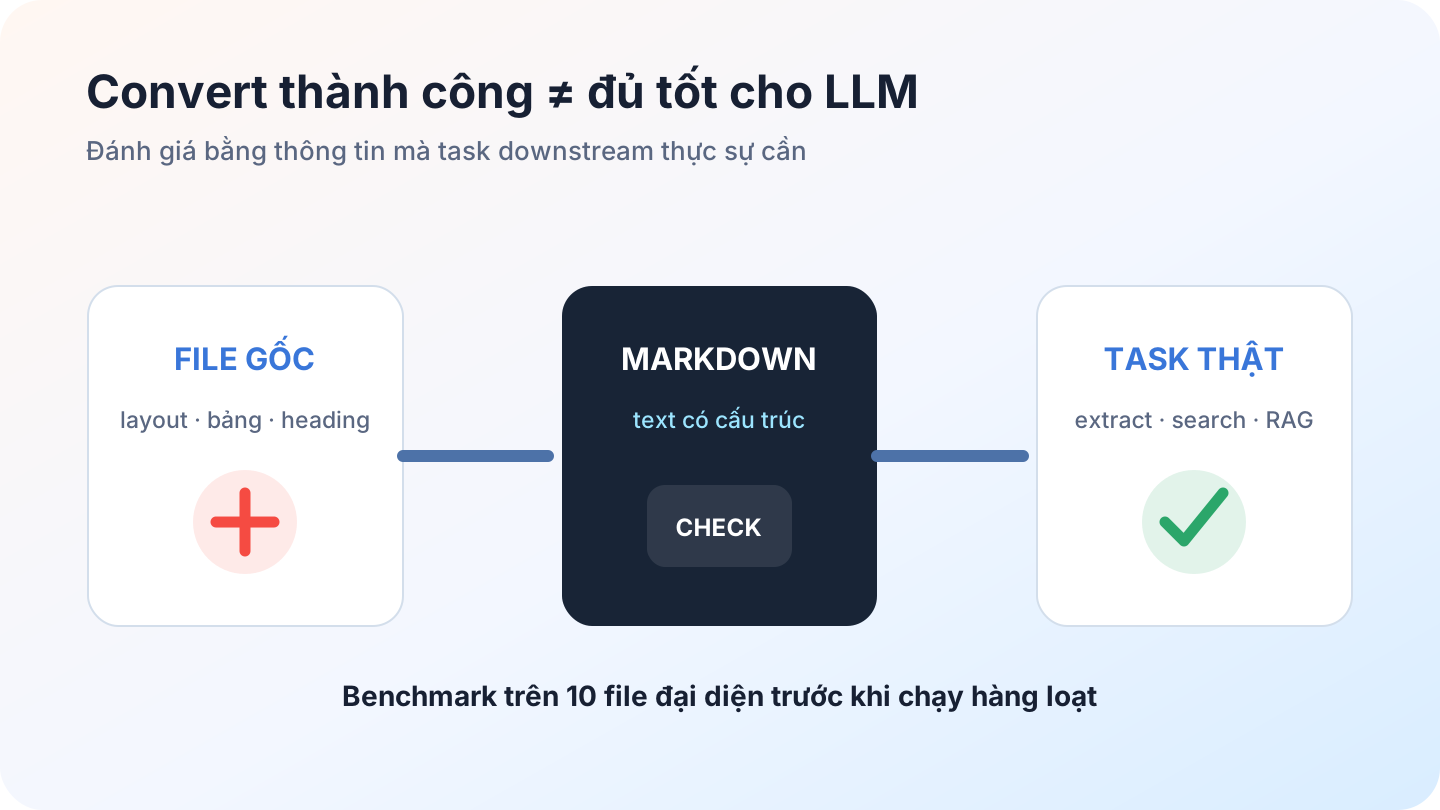
Markdown không phải representation hoàn hảo cho mọi tài liệu. Layout nhiều cột, bảng phức tạp, biểu đồ, handwriting hoặc scan kém chất lượng có thể mất thông tin khi chuyển sang text. Vì vậy “convert thành công” chưa đồng nghĩa với “đủ tốt cho task”.
Nếu input là tài liệu quan trọng, cần benchmark theo câu hỏi downstream. Ví dụ, hãy kiểm tra model có lấy đúng số trong bảng hay nhận đúng heading không, thay vì chỉ nhìn file .md thấy có vẻ sạch.
MarkItDown cũng không thay thế toàn bộ document intelligence. README có integration với Azure Document Intelligence cho một số flow, cho thấy có những trường hợp cần parser chuyên sâu hơn conversion cơ bản.
Khi nào chưa cần dùng?
Nếu ứng dụng chỉ nhận plain text hoặc Markdown ngay từ đầu, thêm MarkItDown sẽ không tạo ra nhiều giá trị.
Bạn cũng chưa cần nó nếu đã có document pipeline ổn định với OCR, layout analysis, table extraction và evaluation rõ ràng. Thay công cụ chỉ vì repo mới nổi có thể làm regression ở những file khó.
Phù hợp với ai?
Repo phù hợp với developer xây LLM app, RAG pipeline, research workflow hoặc agent cần đọc tài liệu. Người mới có thể thử khá nhanh vì CLI đơn giản và Python requirement rõ: README hiện yêu cầu Python 3.10 đến 3.14.
Bắt đầu thực tế như thế nào?
Chọn 10 file đại diện cho dữ liệu thật, không phải chỉ một PDF đẹp. Convert từng file, sau đó kiểm tra các thành phần quan trọng như heading, bảng, link và đoạn văn. Tiếp theo chạy task downstream của bạn trên Markdown đầu ra. Nếu chất lượng ổn định, hãy bọc MarkItDown thành một bước ingest riêng có log lỗi và fallback cho những file type mà converter không xử lý tốt.