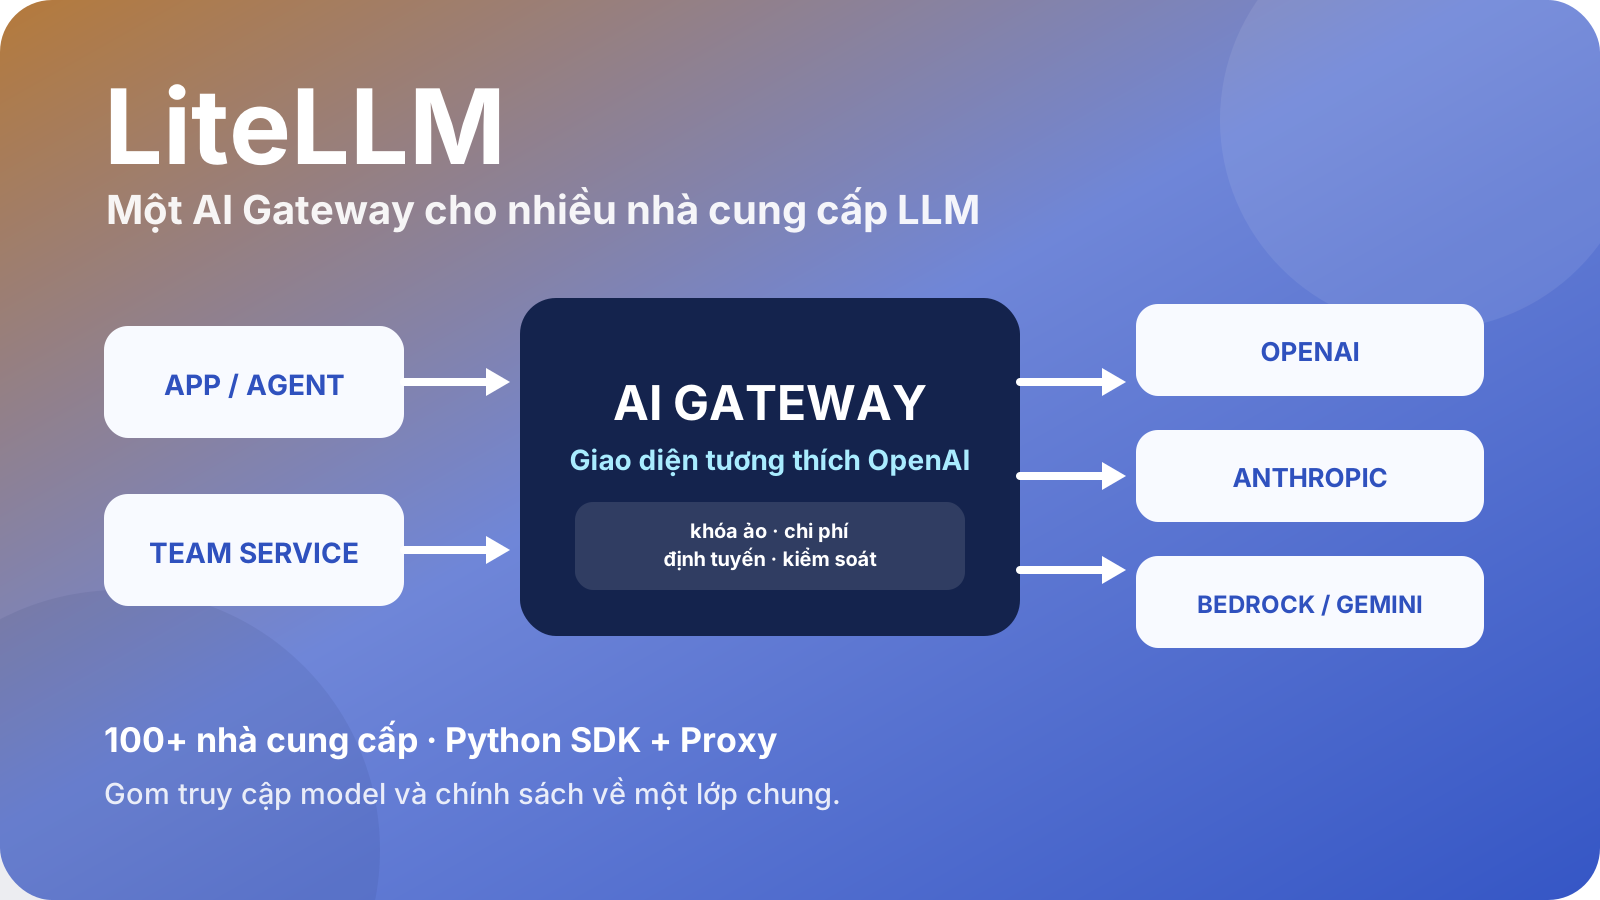
Khi một sản phẩm chỉ gọi một model, tích hợp trực tiếp thường là cách đơn giản nhất. Nhưng khi team dùng OpenAI cho một workflow, Anthropic cho workflow khác, thêm Bedrock hoặc Vertex AI rồi muốn kiểm soát key và chi phí tập trung, phần glue code tăng rất nhanh. LiteLLM đặt một lớp chung giữa ứng dụng và nhiều LLM provider thay vì để mỗi service tự xử lý một kiểu API.
LiteLLM là gì?
LiteLLM là dự án open source có hai cách dùng chính: Python SDK để gọi nhiều provider qua một interface thống nhất, và LiteLLM Proxy để dựng AI Gateway dùng chung. README hiện mô tả hỗ trợ hơn 100 LLM provider và nhiều endpoint theo format tương thích OpenAI.
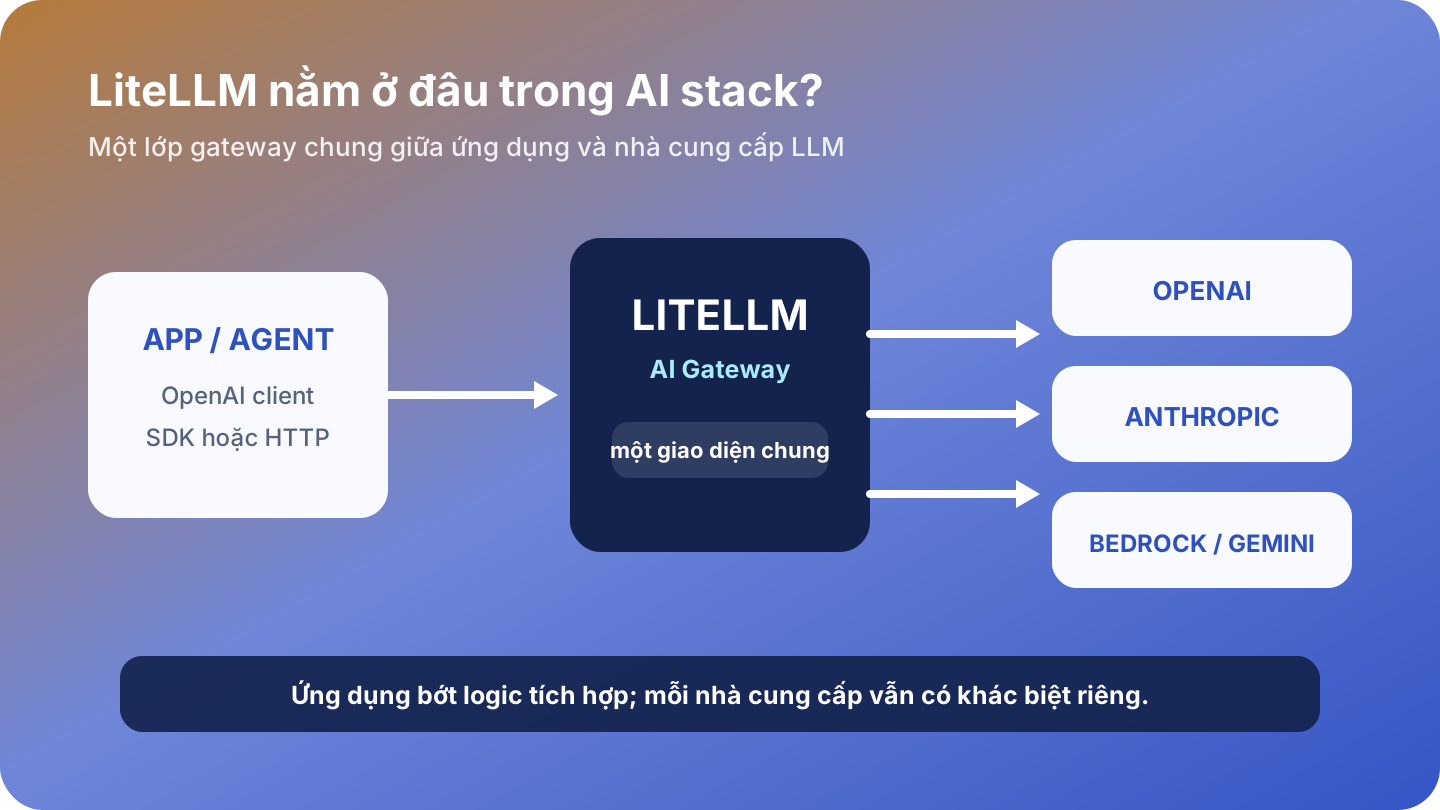
LiteLLM không chạy model; nó nằm ở lớp điều phối phía trước model. Ứng dụng gọi một interface chung, còn gateway xử lý provider, key, routing và policy.
Vì sao repo này đáng chú ý?
Điểm đầu tiên là giảm coupling với SDK riêng của từng provider. Nếu client đã dùng OpenAI-compatible API, LiteLLM Proxy có thể làm endpoint trung gian để đổi model hoặc provider mà không nhét toàn bộ logic tích hợp vào từng ứng dụng.
Điểm thứ hai là gom concern vận hành vào cùng gateway. README hiện liệt kê virtual keys, spend tracking, guardrails, load balancing và admin dashboard. Với nhiều ứng dụng AI, những rule dễ bị rải khắp codebase có thể được quản lý tập trung hơn.
Repo cũng đang được phát triển rất tích cực. Tại thời điểm research ngày 06/10/2026, GitHub ghi nhận 60.172 stars, release ổn định gần nhất là v1.104.0 phát hành ngày 03/10/2026 và nhánh main vẫn có commit mới trong ngày.
Khi nào nên dùng?
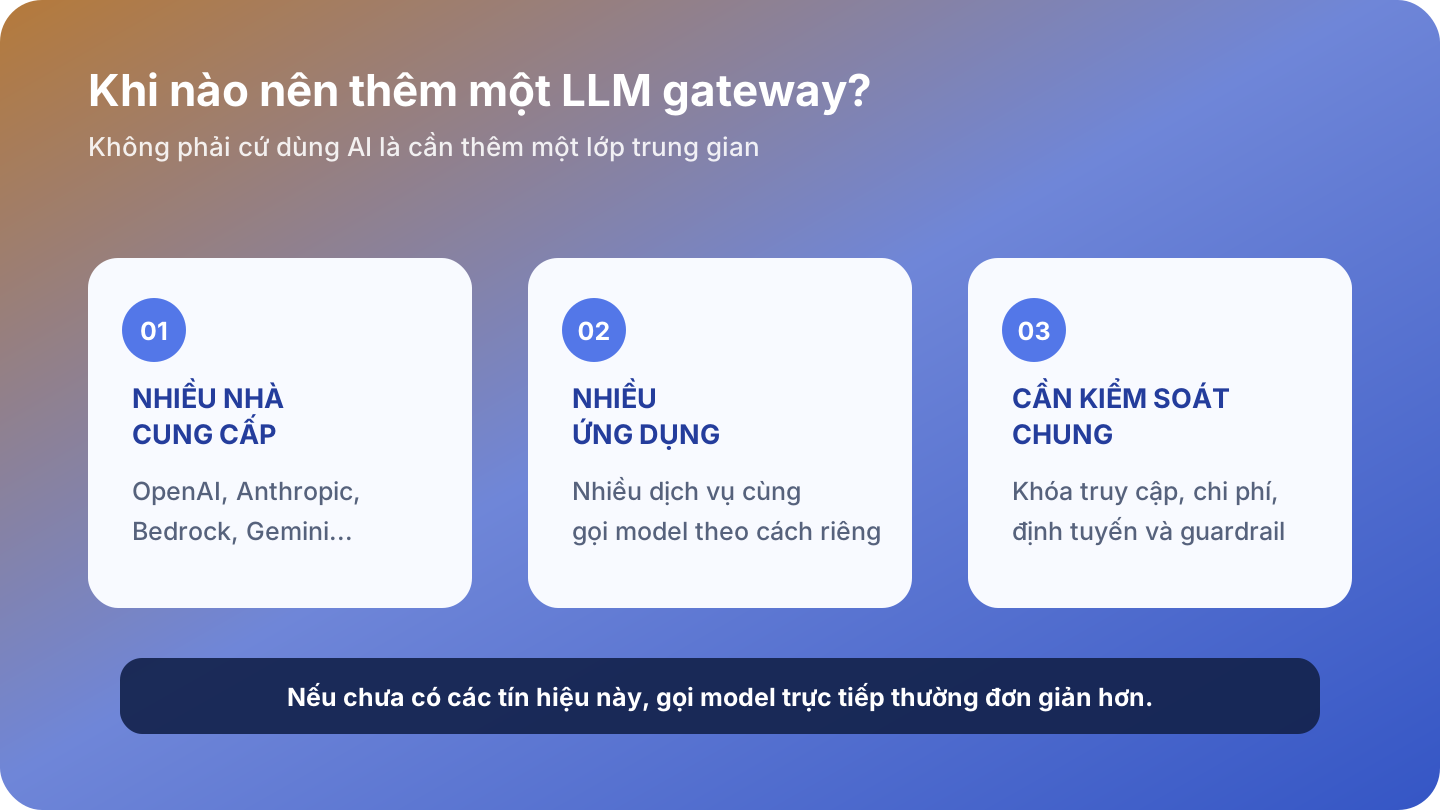
LiteLLM hợp lý khi team đã vượt qua giai đoạn “một app, một API key, một provider” và bắt đầu cần control plane chung cho model access.
Ví dụ điển hình là nhiều nhóm cùng gọi model nhưng không muốn phát credential gốc cho từng ứng dụng. Gateway có thể cấp virtual key và gom usage về một chỗ. Hoặc sản phẩm cần nhiều provider nhưng vẫn muốn giữ client API tương đối ổn định.
Lưu ý trước khi áp dụng
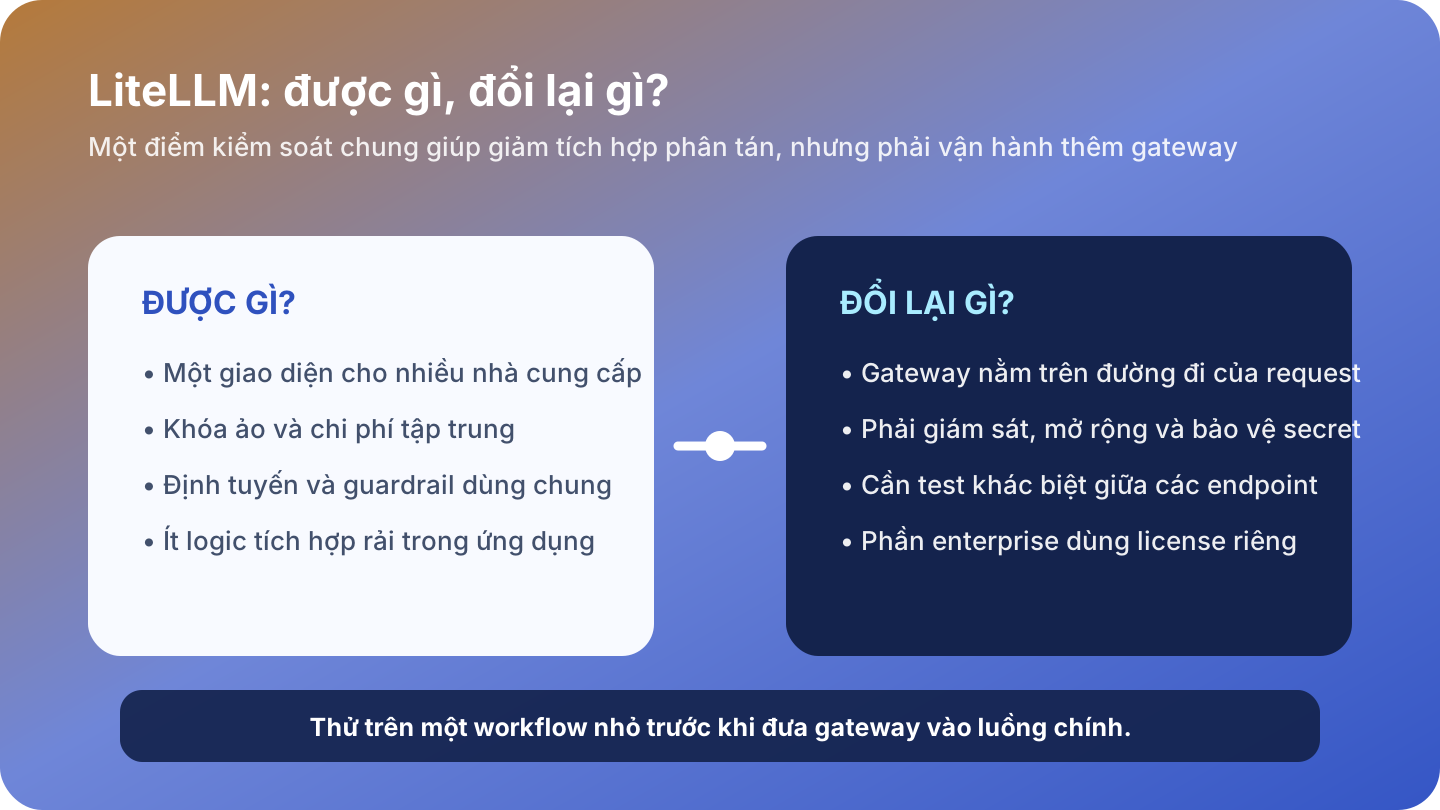
“Unified API” không có nghĩa mọi provider trở nên giống nhau hoàn toàn. Ngay trong README, bảng endpoint cho thấy mức hỗ trợ chat, responses, embeddings, image, audio, batch hoặc rerank khác nhau theo từng provider. Vì vậy team vẫn phải test đúng endpoint và model mình thực sự dùng thay vì giả định có thể đổi backend mà không có khác biệt.
Thứ hai, khi LiteLLM Proxy nằm trên đường đi của mọi request, gateway trở thành hạ tầng quan trọng. Team phải tự lo monitor, scale, bảo vệ secret, xử lý lỗi và mức sẵn sàng phù hợp với workload.
License cũng cần đọc kỹ. File LICENSE của repo quy định phần code ngoài thư mục enterprise/ theo MIT, còn nội dung trong enterprise/ dùng license riêng. Không nên mặc định toàn bộ feature trong repository đều có cùng điều kiện sử dụng.
Khi nào chưa cần dùng?
Nếu bạn chỉ có một ứng dụng nhỏ gọi duy nhất một provider và chưa có vấn đề về key, routing, spend hoặc governance, tích hợp trực tiếp thường dễ hiểu và ít điểm lỗi hơn.
LiteLLM cũng chưa phải ưu tiên nếu vấn đề chính nằm ở prompt, retrieval hoặc evaluation. Một gateway tốt không tự cải thiện chất lượng đầu ra; nó chỉ giúp quản lý lớp truy cập model có hệ thống hơn.
Phù hợp với ai?
LiteLLM phù hợp với platform engineer, AI engineer và backend team đang quản lý nhiều model provider hoặc nhiều ứng dụng AI. Người mới có thể thử Python SDK nhanh, nhưng dùng Proxy như hạ tầng chung đòi hỏi hiểu thêm về auth, observability và vận hành service trung gian.
Bắt đầu thực tế như thế nào?
Đừng đưa toàn bộ traffic qua gateway ngay từ đầu. Chọn một workflow không critical, gọi hai provider qua cùng interface và ghi lại khác biệt về response, error handling và endpoint support. Sau đó dựng Proxy, thêm virtual key, spend tracking và routing tối thiểu. Chỉ mở rộng khi gateway thật sự giảm logic tích hợp mà latency, độ ổn định và công vận hành vẫn chấp nhận được.